
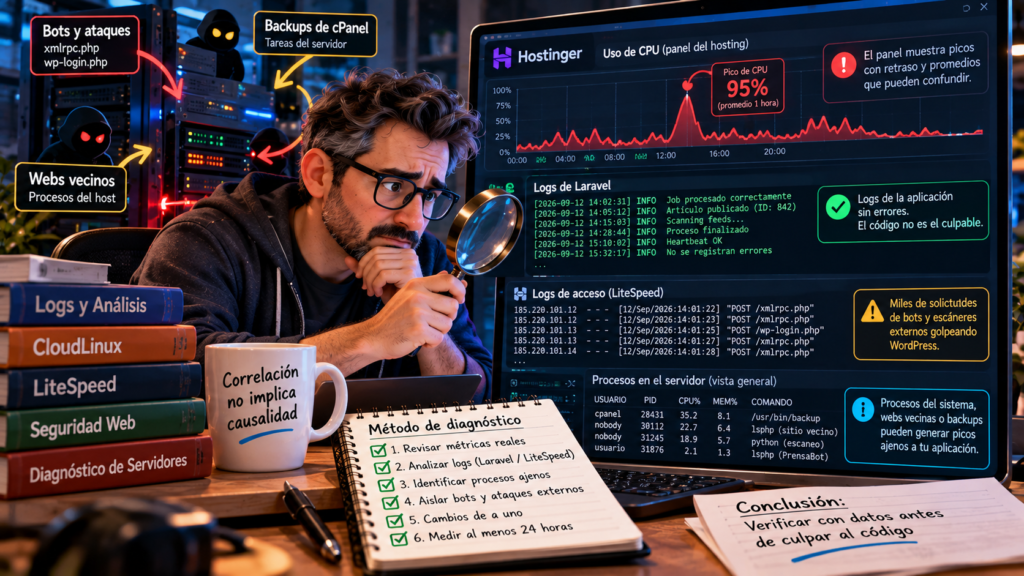
El 12 de septiembre de 2026 quedó marcado como un día de revelación para muchos equipos de desarrollo. Frente a picos de consumo de CPU en servidores compartidos, la reacción instintiva suele ser una: culpar al último despliegue de código. Sin embargo, una investigación metódica demostró que esta presunción puede ser un costoso error, enmascarado por paneles de control que presentan métricas engañosas o desfasadas en el tiempo.
La ilusión de los paneles promediados
El problema inicial radica en la forma en que muchos paneles de hosting, especialmente en entornos compartidos como cPanel o Hostinger, muestran los datos. Estos sistemas suelen promediar el consumo de recursos o presentar picos con horas de retraso respecto al incidente real. Esta discrepancia temporal crea una falsa correlación: un desarrollador ve un pico de CPU a las 14:00 horas en el panel y, recordando un despliegue realizado a las 13:30, asume una relación causal directa. La realidad, no obstante, puede ser completamente distinta.
El método del detective: triaje con datos duros
La solución efectiva no reside en el pánico, sino en una rutina metódica de investigación. Lo que funcionó fue desarrollar un protocolo de triaje basado en la correlación de múltiples fuentes de información primaria, desconfiando de los paneles gráficos. El proceso se estructuró en pasos clave:
-
Aislar procesos ajenos: Revisar los logs de acceso del servidor web (como LiteSpeed) para identificar tráfico malicioso. Un patrón común son ataques de bots masivos golpeando endpoints como `xmlrpc.php` en instalaciones de WordPress, incluso en servidores que alojan aplicaciones Laravel.
-
Validar el origen del consumo: Distinguir si la alta utilización de memoria o CPU proviene de los procesos PHP de la aplicación o de tareas del sistema, cronjobs del hosting (como copias de seguridad) o, incluso, de la actividad de otros sitios alojados en el mismo servidor (el 'vecino ruidoso').
-
Modificar con paciencia: Implementar cambios de configuración de uno en uno, midiendo el impacto durante al menos 24 horas antes de sacar conclusiones. Revertir cambios de código de manera frenética sin este análisis previo demostró ser inefectivo y contraproducente.
Correlación no es causalidad en infraestructura compartida
El aprendizaje fundamental es un principio de la estadística aplicado a la administración de sistemas: en un entorno compartido, la correlación temporal no implica causalidad. Un pico en el gráfico del panel que coincide con un despliegue reciente puede ser pura coincidencia, enmascarando el verdadero problema, como un ataque distribuido de fuerza bruta o una tarea programada del propio proveedor de hosting.
La clave reside en pasar de la suposición a la evidencia. Cruzar los timestamps exactos de los logs de aplicación de Laravel (`storage/logs/`), con los logs de acceso del servidor y los informes detallados de sistemas como CloudLinux, permite construir una línea de tiempo precisa y objetiva. Solo con estos 'datos duros' se puede determinar si el cuello de botella es interno de la aplicación o externo, originado en el 'vecindario' del servidor.
Deja una respuesta