
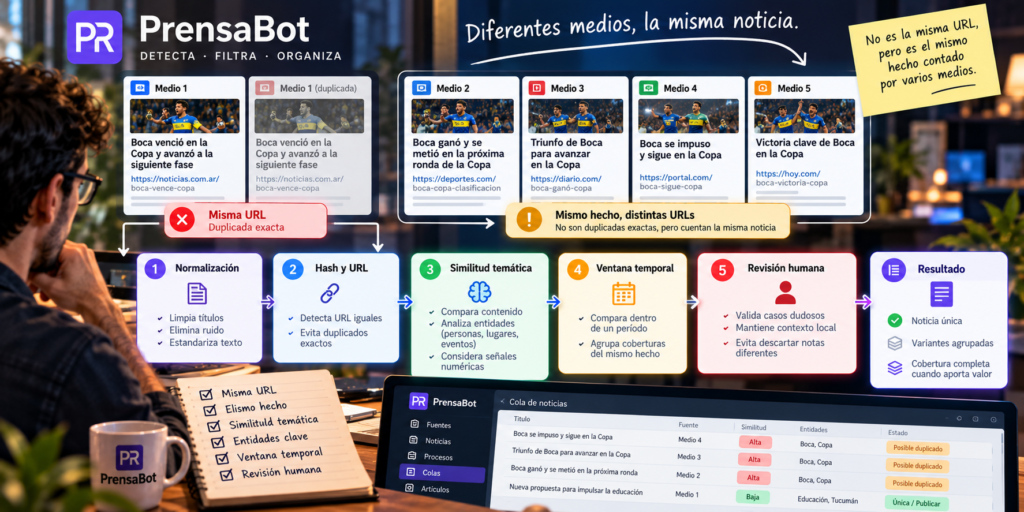
En el corazón de cualquier sistema automatizado de noticias late un problema aparentemente simple, pero técnicamente complejo: evitar que el mismo hecho periodístico, contado por decenas de medios distintos, inunde los canales de publicación. PrensaBot, la plataforma SaaS construida con Laravel y Filament, aprendió esta lección de la manera más cruda durante la intensa cobertura de la crisis deportiva y los partidos de Boca Juniors. Las primeras comprobaciones, basadas únicamente en URL y hash, eran eficaces para bloquear copias literales de una misma fuente, pero resultaron completamente ciegas ante la realidad del ecosistema mediático: un solo evento genera cientos de notas originales, con ángulos y fuentes locales diferentes.
Del hash simple al análisis contextual multidimensional
La estrategia inicial era directa: si una URL o un hash idéntico ya habían sido procesados, el sistema descartaba el contenido. Este método, sin embargo, no distinguía entre una repetición técnica y la cobertura simultánea de un evento masivo. El intento de corregir este fallo bajando drásticamente el umbral de similitud semántica generó un efecto colateral grave: comenzaron a descartarse notas legítimas de medios locales o con enfoques particulares, simplemente porque hablaban del mismo partido o declaración. La solución no podía ser binaria.
La fórmula híbrida: máquina, tiempo y criterio editorial
Para superar el impasse, el equipo de desarrollo implementó un sistema de filtrado multicapa que evalúa cada contenido potencial desde múltiples perspectivas antes de decidir si es una duplicación no deseada. Este proceso combina:
-
Verificación técnica básica: URL y hash, para captar las copias exactas.
-
Análisis semántico y de entidades: Comparación del título, cuerpo y las entidades nombradas (club, jugador, estadio, resultado).
-
Detección de señales numéricas: Identificación de datos únicos como marcadores, estadísticas o cifras específicas.
-
Ventana temporal: Contextualización del momento de publicación. Una noticia sobre un gol puede tener decenas de versiones en minutos, pero un análisis posterior días después es probablemente una duplicación.
-
Revisión humana como último filtro: La capa final que permite ajustar el criterio y salvar notas valiosas que un algoritmo puro podría eliminar.
Por qué no existe un umbral mágico universal
Uno de los aprendizajes clave fue que ningún porcentaje o umbral de similitud funciona igual para todos los temas. Un partido de fútbol, una conferencia de prensa gubernamental o el lanzamiento de un producto tecnológico generan patrones de cobertura radicalmente distintos. Mientras que en deportes la redundancia de datos (el resultado) es alta pero el ángulo local es valioso, en tecnología un anuncio puede ser idéntico en todas las fuentes. Por ello, el sistema mantiene un umbral conservador por defecto, pero está diseñado para que las reglas editoriales específicas de cada organización cliente puedan ajustar la sensibilidad según la temática, priorizando la exhaustividad o la unicidad según su estrategia.
Este enfoque híbrido transformó a PrensaBot de un simple recolector en un curador inteligente de información. Ya no se trata solo de evitar lo idéntico, sino de gestionar lo similar, un desafío que define la calidad y relevancia de cualquier flujo de noticias automatizado en la era de la sobreinformación.
Deja una respuesta