
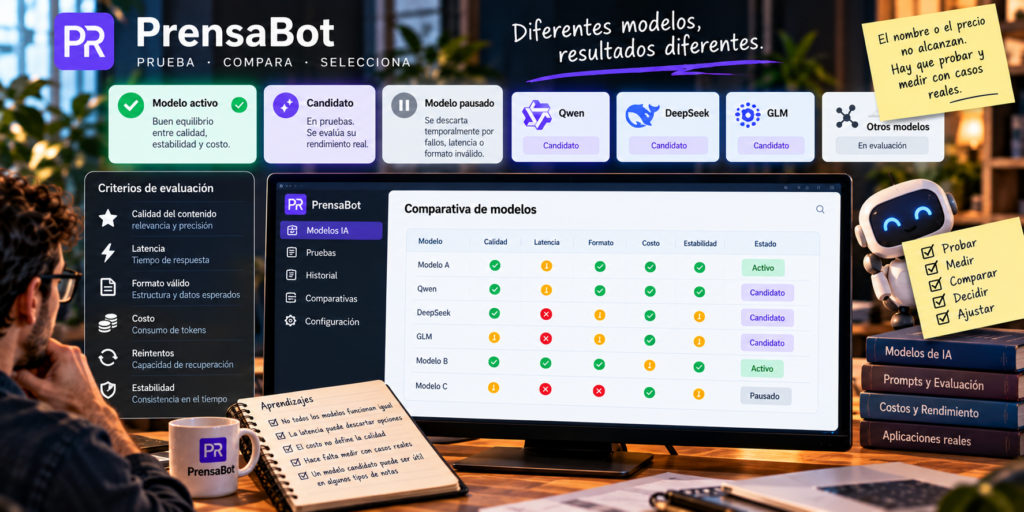
En el ecosistema de la inteligencia artificial, la discusión suele centrarse en especificaciones técnicas, precios por token o popularidad del modelo. Sin embargo, implementar una IA para un producto SaaS real, como PrensaBot, exige un enfoque diametralmente opuesto: la evaluación debe ser sistemática, cuantitativa y orientada a la operación continua. La plataforma, que nació para automatizar la gestión de contenidos periodísticos y hoy conecta organizaciones con sus sitios WordPress, desarrolló una metodología de benchmark que trata a cada modelo como un componente productivo, no como una hipótesis académica.
Más Allá del Nombre y el Precio: Las Métricas que Importan
La experiencia documentada por el equipo de PrensaBot es clara: elegir un modelo solo por su fama o su costo por token es un camino directo al fracaso en producción. Durante sus pruebas, modelos como Qwen, DeepSeek y GLM demostraron capacidad de respuesta, pero también exhibieron fallos intermitentes, latencias variables y patrones de consumo impredecibles cuando se los contrastó con los modelos ya activos en el sistema. La simple comparación nominal resultó insuficiente.
Frente a esto, se estableció un protocolo de medición multicriterio. La calidad de la respuesta (aciertos vs. fallos), la latencia de generación, el cumplimiento estricto del formato de salida requerido, el costo operativo y la estabilidad en el tiempo se convirtieron en los ejes centrales. Para simular condiciones reales, se definió un límite de tiempo estricto para la generación. Un límite fijo inicial de 25 segundos descartó de plano a varios modelos económicos que no podían cumplirlo, lo que llevó a ajustar la prueba con un presupuesto total de hasta 90 segundos y ventanas de 45 segundos para candidatos específicos.
Candidatos, Activos y Pausados: Los Estados de un Modelo en Producción
La metodología introdujo una clasificación operativa clave para la gestión del ciclo de vida de los modelos dentro de la plataforma SaaS:
- Modelo Candidato: Es aquel que ingresa al proceso de benchmark. Se somete a pruebas intensivas, pero ninguna de sus notas generadas se publica durante esta fase de calibración. Su desempeño se mide en un entorno controlado.
- Modelo Activo: Supera el benchmark y está aprobado para uso en producción. Gestiona colas de trabajo reales, aplica reglas editoriales y publica contenido en los sitios WordPress conectados.
- Modelo Pausado: Un modelo que fue activo pero que, por cambios en los requisitos, actualizaciones o problemas de rendimiento/costo, se desactiva temporalmente. Permanece en el sistema para posible reutilización futura.
Este flujo asegura que la transición de un modelo del laboratorio a la línea de producción sea segura y basada en datos, minimizando el impacto en los usuarios finales de la plataforma.
El aprendizaje final es contundente: en el negocio del software, la inteligencia artificial es un proveedor de servicios crítico. Su selección no puede depender de tendencias o discusiones superficiales. Requiere un benchmark riguroso que ponga a prueba su fiabilidad bajo las condiciones específicas de carga, formato y tiempo que exige el producto. Solo así se puede garantizar la estabilidad del servicio y la confianza de las organizaciones que dependen de la automatización para su comunicación digital.
Deja una respuesta