
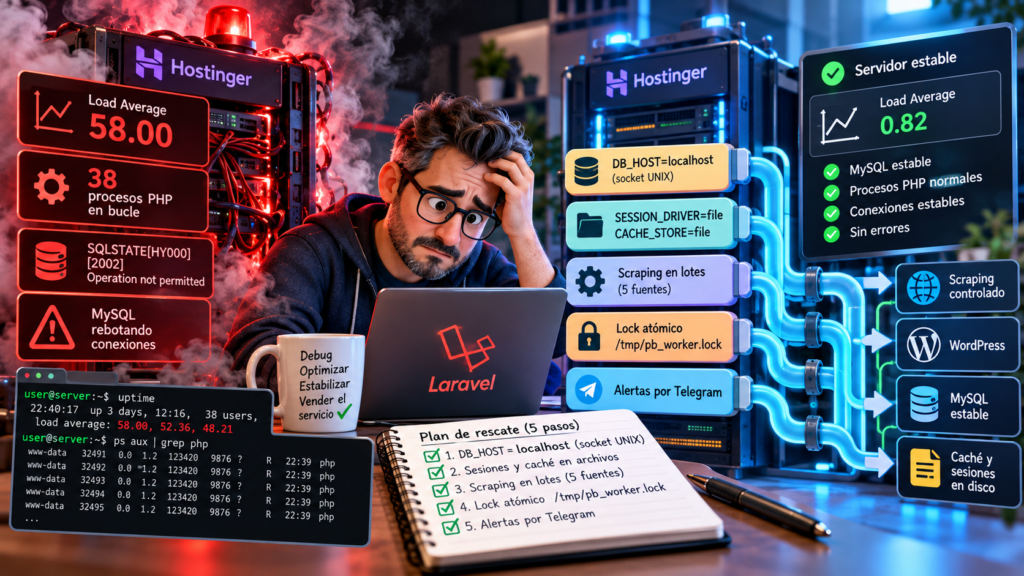
El viernes 11 de septiembre de 2026, a las 22:40, una alerta de monitoreo activó todas las alarmas. El servidor compartido br-asc-web1841 de Hostinger había entrado en estado crítico: su Load Average, una métrica que mide la carga del sistema, se había disparado a un valor escalofriante de 58. En paralelo, 38 procesos PHP estaban trabados en un bucle infinito y el servicio de MySQL comenzaba a rechazar conexiones con el error SQLSTATE[HY000] [2002] Operation not permitted. El administrador, ante la emergencia, pidió un rescate urgente con un mandato claro: blindar el servicio para que no volviera a suceder.
La trampa invisible de CloudLinux en hosting compartido
El incidente no fue un fallo aleatorio, sino la consecuencia directa de operar una aplicación compleja como Laravel en un entorno con restricciones estrictas. Los planes de hosting compartido, especialmente aquellos que utilizan CloudLinux y LiteSpeed, aplican límites de recursos por usuario (LVE) que son invisibles hasta que se superan. Estos límites incluyen cuotas de sockets TCP para conexiones de loopback, memoria máxima por proceso y tiempo de CPU. Cuando la aplicación, diseñada para un entorno más permisivo, intentó ejecutar múltiples tareas de fondo simultáneamente, chocó contra estos muros y provocó el colapso en cascada del servidor.
La cirugía técnica en cinco movimientos clave
El diagnóstico forense vía SSH identificó los cuellos de botella. La solución no requirió cambiar a un servidor dedicado, sino una reingeniería precisa para respetar los límites de la infraestructura existente. La intervención se basó en cinco cambios fundamentales:
-
Cambio de conexión a la base de datos: Se modificó DB_HOST=127.0.0.1 por localhost en el archivo .env. Esto forzó a PHP a usar sockets UNIX nativos para comunicarse con MySQL, liberando la cuota limitada de sockets TCP loopback que saturaba CloudLinux.
-
Descarga masiva de MySQL: Las sesiones y la caché, que usaban MySQL por defecto en Laravel, se migraron al sistema de archivos (SESSION_DRIVER=file, CACHE_STORE=file). Esto eliminó cientos de consultas por segundo generadas por el polling de componentes Livewire.
-
Control estricto de tareas de fondo: Se restringió el scraping de datos externos a lotes de máximo 5 fuentes por ejecución, evitando picos de concurrencia.
-
Lock unificado para workers: Se implementó un sistema de lock atómico en /tmp/pb_worker.lock para garantizar que solo una instancia de procesamiento en segundo plano se ejecutara a la vez.
-
Alertamiento proactivo: Se configuraron notificaciones automáticas vía Telegram para monitorear cualquier anomalía en tiempo real.
Lo que no funcionó y el aprendizaje definitivo
Una estrategia común en entornos propios, como lanzar workers de cola persistentes con queue:work, resultó contraproducente. En hosting compartido, los procesos de larga duración son terminados automáticamente por el sistema, generando inestabilidad. La lección final es contundente: la escalabilidad no depende necesariamente de un hardware más caro. Depende de comprender a fondo las restricciones del kernel y del entorno para diseñar una arquitectura de software que opere eficientemente dentro de esos límites. Tras la intervención, el Load Average del servidor se estabilizó en 0.8, demostrando que con optimización inteligente, un SaaS rentable puede funcionar en infraestructura accesible.
Deja una respuesta